
ai-agents48.9 КБ
Память AI-агентов: что помнить, где хранить и как забывать
Почему большое контекстное окно и векторная база ещё не память, где она ломается и почему я не советую ставить систему памяти, пока не можешь назвать проблему.
Я пользовался встроенной памятью Claude Code. Записывает он её в свою папку .claude в домашней директории, поэтому знание остаётся на компьютере и вместе с репозиторием никуда не едет1. А работаю я с двух компьютеров, и на одном из них память всегда была устаревшей. Я уже поменял всю архитектуру, а агент думал, что у меня всё как месяц назад, и исходя из этого принимал неверные решения.
Эту историю я рассказывал на митапе, где делал доклад про память AI-агентов. А начал его с того, что слово «память» все понимают по-разному: кому-то нужно сохранять все транскрипты, кто-то считает памятью векторную базу. В этой статье я пересказываю доклад: что вообще называть памятью, где она ломается и что из этого нужно именно вам. Вывод у доклада был такой: ставить какие-то системы памяти я не рекомендую.
Пример вместо определения
Представьте проект. В понедельник мы решили, что используем Kafka. Через месяц переехали на NATS. Ещё через месяц кто-то спрашивает агента: а какой у нас брокер?
Чтобы ответить правильно, системе пришлось проделать много работы. В конце первой сессии решить, что выбор Kafka стоит запомнить. Потом запомнить переезд на NATS. Понять, что новый факт конфликтует со старым, и перестать считать Kafka актуальной. А на вопрос достать только NATS, без Kafka в придачу. И, возможно, сохранить историю — вдруг спросят, что у нас было в феврале.
Вот всё это вместе я и называю памятью. Ни один из этих шагов не решается тем, что мы сложили историю разговоров в базу. Если хоть один шаг пропущен, агент начинает врать: в зависимости от того, как он сформулирует запрос к памяти, получит то Kafka, то NATS.
Почему большое контекстное окно не спасает
Окна у моделей уже огромные, и сначала кажется, что больше ничего придумывать не надо. Только контекст отвечает на другой вопрос: что модель видит прямо сейчас. Состояния у модели нет, мы каждый раз заново отправляем ей всю переписку. Сессия закончилась — закончилась и память. Транскрипт остаётся, но если скормить его следующей сессии, он опять забьёт контекст, и вполне возможно не той информацией, которая нужна.
Когда окно всё-таки переполняется, у харнесов есть три приёма. Выкинуть начало переписки. Выкинуть середину, чтобы остался исходный вопрос. Или сделать суммаризацию: модель будет помнить, о чём шла речь, но без деталей, и с каждым проходом деталей остаётся всё меньше. Ни один приём не решает задачу памяти: каждый просто выбирает, какую часть прошлого потерять.
Есть и вторая проблема — context rot. Модели хуже находят то, что лежит в середине длинного контекста, чем то, что в начале или в конце2. Chroma проверила 18 моделей и показала, что дело не только в позиции: даже один похожий по теме отвлекающий фрагмент уже снижает точность, а несколько складываются3. На LongMemEval короткий промпт примерно в 300 токенов у всех проверенных моделей отвечал заметно лучше полного примерно на 113 тысяч. Самый большой разрыв в этом опыте оказался у семейства Claude, а не у локальных моделей, как я сказал в докладе. Мой пример с нумерацией сообщений был именно личным наблюдением: модель цеплялась за случайно заданный паттерн. Исследование Chroma этого частного эффекта не проверяло.
Есть решения, которые экономят контекст, выкидывая из истории результаты выполнения команд. Тут есть цена: prompt caching работает по совпадающему префиксу, поэтому правка старого сообщения инвалидирует кэш от этого места и дальше4. Если вырезали ранние результаты команд, пересчитать придётся большую часть длинной истории, а не обязательно весь промпт целиком.
Почему все спорят о поиске
Если разложить память на шаги, получится цикл. Сначала решить, что вообще достойно памяти. Потом решить, в каком виде это знание хранить. Затем в нужный момент найти его, подать модели, получить ответ — и обновить или забыть то, что устарело. Вот про последний шаг, к сожалению, мало кто помнит.
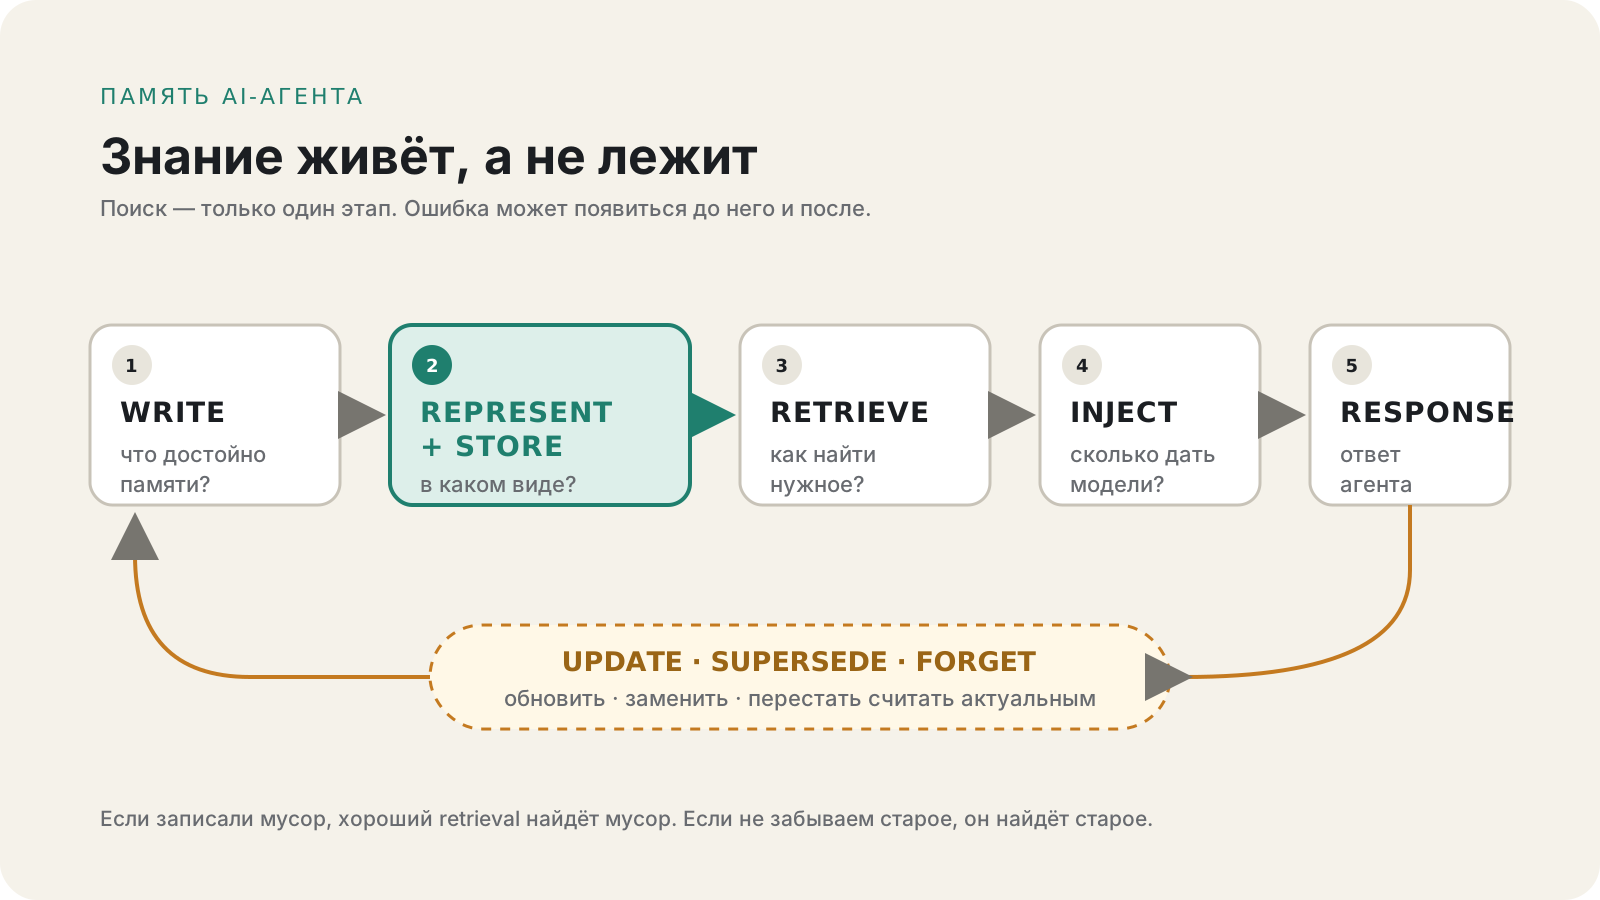
Запись и поиск разные решения делают по-разному. Кто-то вешает хуки и пишет в память по правилам или ключевым словам. Кто-то даёт модели инструмент «запомнить» и надеется на её дисциплину: она может вызывать его слишком часто, а может не вызвать вообще. Есть офлайн-вариант, когда после диалога другая модель пережёвывает весь транскрипт и решает, что сохранить, — но это дополнительные токены. С поиском так же: либо у модели есть инструмент поиска и она сама решает, когда его звать, либо хук сам подмешивает найденное прямо в сообщение.
В обзорах систем памяти почти весь разговор про поиск: какую взять embedding-модель, какой реранкер, pgvector или Milvus, BM25 или косинус. Но самые неприятные ошибки происходят до поиска и после него. Мы записали мусор. Знание устарело, и мы прекрасно нашли не то состояние. Или мы вообще ничего не забываем, база разрастается, и на тот же запрос возвращается всё больше контекста. Система медленно деградирует, пока вы не заметите, что каждый вызов стал стоить очень дорого.
Что помнить
Типы памяти обычно берут из когнитивной психологии как удобную инженерную классификацию, а не буквальную модель мозга. Рабочая — то, что нужно прямо сейчас: текущая задача, открытые файлы, вывод последней команды. По сути, это и есть контекст. Эпизодическая — что происходило и когда: в четверг дебажили такой-то тест, закончилось таймаутом. Семантическая — что мы считаем истинным. Процедурная — как что-то делать. Пятым часто выделяют профиль с предпочтениями вроде «отвечай коротко» и «не пиши комментарии»: он живёт дольше проекта и переезжает вместе с человеком.
Иногда один тип превращается в другой. Тест три раза упал с таймаутом в пять секунд — это эпизод. Повторилось несколько раз, и мы решили, что этому тесту нужно 30 секунд, — это уже семантический факт. Стало рутиной — появляется процедура: при настройке этого теста ставь 30 секунд. Модель при этом никто не дообучал. Агент научился на опыте потому, что изменилось представление накопленного знания. Так бывает не всегда, эпизод не обязан во что-то превращаться. Но система, которая копит эпизоды и никогда их не обобщает, превращается в архив.
На практике большинству хватает семантической памяти и немного процедурной. Если вы каждую сессию объясняете агенту одно и то же или в третий раз диктуете ту же последовательность действий, память нужна, хоть какая-то. Всё остальное скорее не нужно.
Текст, векторы, граф и время
Текст, эмбеддинги, граф и время часто обсуждают как конкурирующие варианты. Но это уровни обогащения одной и той же записи, и каждый следующий добавляет к ней новое свойство, а предыдущие остаются. Пройдём их на одном факте: «Алиса руководит Project X».
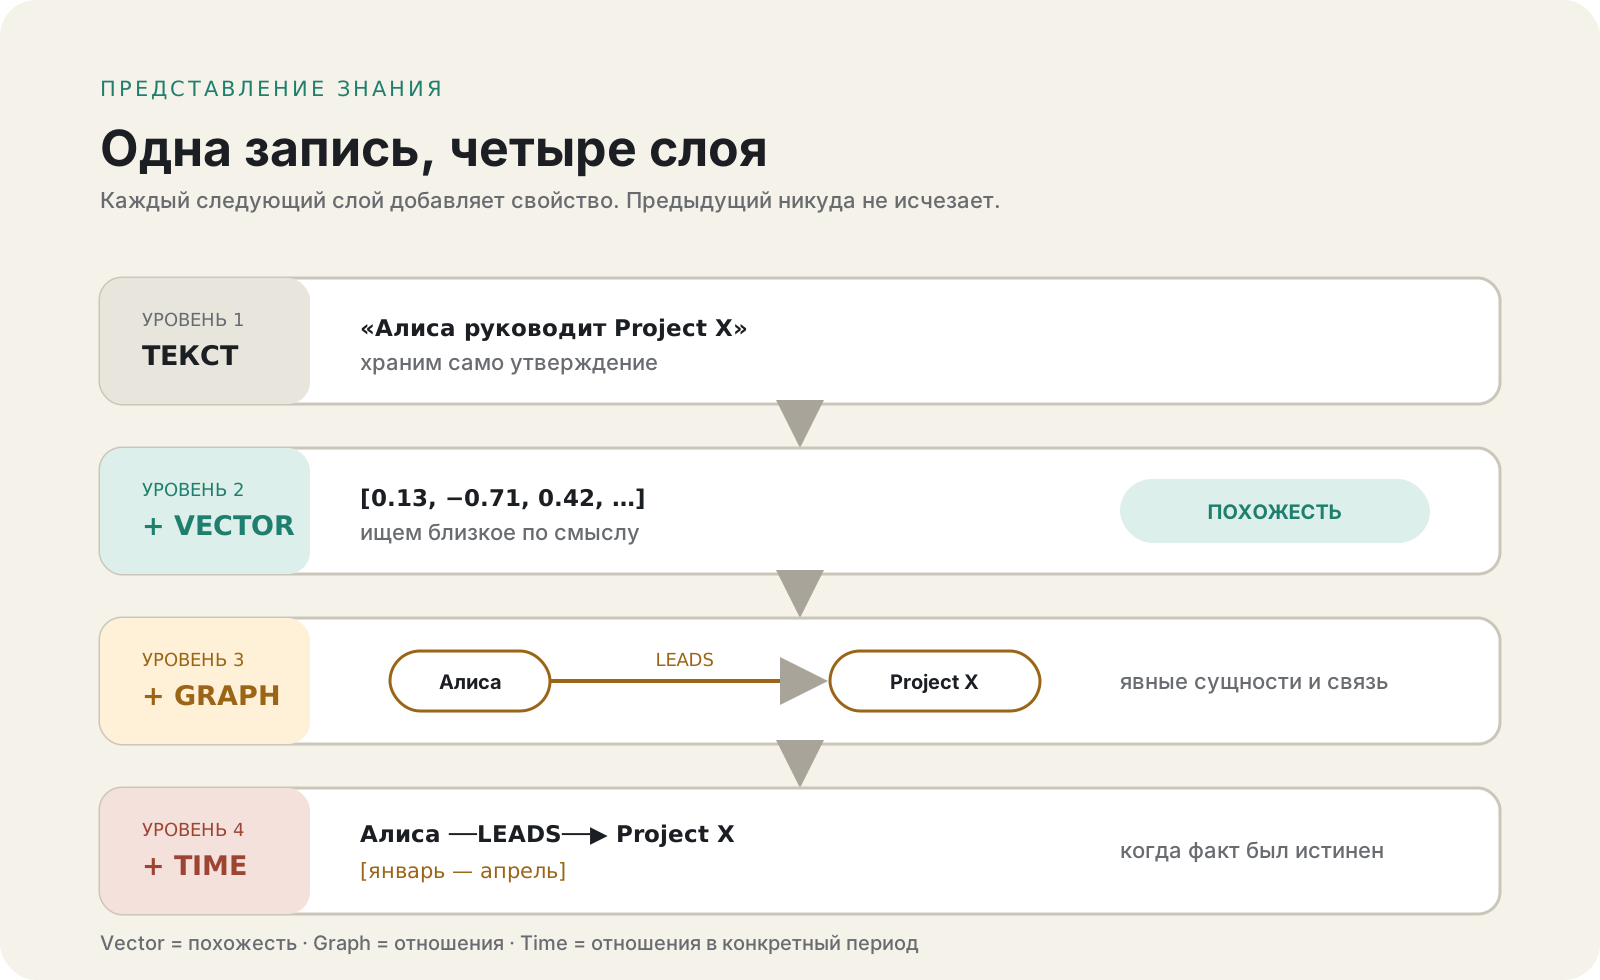
Первый уровень — просто текст. Кладём его в MEMORY.md, JSON или SQLite, а находим чтением файла, grep, SQL или полнотекстовым поиском. Никакого искусственного интеллекта здесь не требуется. И у файлов куча плюсов: всё видно, изменения памяти приходят в git diff и проходят ревью, запись легко удалить, понятно, откуда взялся факт, и почти не нужна инфраструктура. Минус один: бесконечным файл быть не может, его придётся консолидировать и чистить. На технических текстах полнотекстовый поиск часто сильнее векторного, потому что половина запроса — точные идентификаторы: имя сервиса, код ошибки, номер тикета. Эмбеддинг такое размывает. Поэтому харнесы обычно делают grep и не парятся.
Второй уровень — эмбеддинг. Фразу превращаем в вектор, и теперь можно искать по смыслу, даже если слова не совпадают. «Проект X возглавила Алиса» и «Алиса руководит Project X» получат почти одинаковые векторы, и по вопросу «кто отвечает за Project X?» мы найдём запись, хотя ни одно слово не совпало. Эмбеддинг-модель и реранкер не бесплатные, но модельки простые и работают практически на любом железе.
Отсюда частое заблуждение, что векторная база и есть память. Векторная база — это индекс, один из способов найти запись памяти. Сам смысл хранится в тексте записи, вектор нужен, чтобы её найти. Вектор говорит, что фразы похожи, но не может сказать, какая из них верна. «Используем Kafka» и «больше не используем Kafka» семантически почти одно и то же, и поиск вернёт обе. На вектор можно навесить таймстемпы, фильтры по метаданным и разрешение конфликтов, и многие так и делают. Похожесть сама по себе просто не отличает верное от неверного — для этого нужен другой механизм.
Спор «память — это просто RAG» возникает из-за похожей механики поиска. Но единица RAG — кусок внешнего корпуса, жизненным циклом которого управляют отдельно от запроса. Типичный вопрос к нему: что написано в документации? Единица памяти — факт, часто решение из диалога с агентом. Память должна уметь его записать, обновить и перестать считать текущим. Типичный вопрос к ней: что мы решили и что из этого ещё верно? Так что RAG не устарел, он решает другую задачу. В агенте часто нужны оба: RAG по документации и коду, память по проекту и договорённостям.
Граф и время
Третий уровень — граф. Здесь предложение раскладывается на сущности и отношения: Алиса руководит Project X, Project X использует Kafka. Это сильно помогает, когда нужна цепочка связей. На вопрос «кто руководит проектом, который использует Kafka?» графовая база пройдёт по рёбрам и вернёт весь путь. Вектор моделирует близость, граф моделирует отношения. Поэтому выбор «векторная база или графовая» — ложный: в графе вполне могут лежать эмбеддинги, и можно сначала найти узлы по смыслу, а потом пройти от них по связям. Многие системы совмещают несколько способов поиска, но это не обязательное свойство памяти. У графа есть цена: знание структурируется при записи. Извлечь сущности, определить отношение, разрешить дубли, найти противоречие — это несколько вызовов модели на каждое сообщение. Для кодинг-агента в одном репозитории это обычно избыточно.
Четвёртый уровень — время. Допустим, в графе два ребра: Алиса руководит Project X и Боб руководит Project X. Кто руководит сейчас? Без понятия актуальности оба ребра одинаково допустимы. Можно завести флаг «текущий», но тогда не ответишь, кто руководил в феврале, и не опишешь период, когда руководителей было двое. Во временном графе время — часть самого факта: у Алисы интервал с января по апрель, у Боба с апреля и дальше. Когда появляется новое ребро, у старого просто закрывается интервал, и оно остаётся в истории.
Тонкость в том, что времени два. Первое — когда факт был правдой в мире. Второе — когда об этом узнала система. В марте агенту сообщили, что на NATS мы перешли ещё в январе. Факт истинен с января, а система знает о нём с марта. Вторая ось позволяет ответить на вопрос, что агент считал истиной пятого марта, и понять, что в тот момент у него просто не было информации. Для разбора инцидентов это очень полезно. Похожую задачу решают и аудит-таблицы, и event sourcing, но здесь время встроено прямо в единицу памяти.
Кто управляет памятью
Это отдельный вопрос, и он не про хранилище. Решать, что записать, что найти и что забыть, могут правила, а может сам агент.
Правила — это «записывать каждые N ходов», время жизни записи, top-k при поиске, компакция при заполнении контекста на 80%. Такая система предсказуема и воспроизводима, легко понять, почему что-то произошло или не произошло. Но она туповата: правило может не покрыть нужный случай и не отличает важное от шума.
Когда управляет агент, модель сама решает: этот факт стоит сохранить, этот устарел, сейчас надо поискать в памяти. Это гибче, но появляется новый класс ошибок, потому что модель недетерминированна. Обычная программа, ошибившись, бросает исключение. Агент, который решил не сохранять важный факт, удалил полезную память или не вызвал поиск, когда было нужно, никакого исключения не бросит. Ответ просто станет немного хуже, и вы об этом в ближайшее время не узнаете.
Что записывать и как забывать
Раз главные ошибки происходят на входе, то и чинить надо вход. Первое правило: запоминать по умолчанию — плохая идея. У Codex, например, модель, которая извлекает воспоминания из сессии, прямо предупреждена, что ничего не записать — допустимо и предпочтительно5. Второе: запись с правом вето. Модель предлагает записать или показывает в конце сессии, что записала, а вы соглашаетесь или отменяете. Если всё тихо пишется в фоне, получится просто мусор.
Третье: не писать то, что можно вывести. Если решение можно прочитать в коде, в комментарии или в коммите, дублировать его в памяти не нужно. Память — только про знание, которого нет в репозитории. Четвёртое: жёсткий лимит размера. Он работает как механизм: принуждает модель консолидировать, и память становится чище. Какие-то детали потеряются, но, может быть, они были не так уж нужны. И пятое: явная привязка к проекту. Бывает, что собирают вообще все транскрипты всех агентов по всем проектам в надежде получить какое-то суперзнание. Обычно не получается: то, что верно для одного проекта, неверно для другого, и агент начинает принимать неправильные решения.
Теперь про забывание. «Забыть» — это четыре разных механизма. Удалить запись, когда она больше не нужна или содержит персональные данные. Заменить старый факт новым, если история не нужна. Оставить старый факт в истории, но перестать считать его текущим, если нужно отвечать «а что было в феврале». И консолидировать много близких воспоминаний в одно общее. Сваливать всё это в один инструмент forget нельзя. Интервал актуальности нужен там, где важна история. Если истории не надо, удалить нормально и дешевле.
Ещё одна ловушка: удалить строку не всегда значит удалить факт. Если путь удаления не каскадный, производные могут остаться в эмбеддингах, поисковом индексе, графе, саммари или снапшотах. Значит, удаление надо проектировать сразу для всех слоёв, а потом проверять чтением, что факт действительно больше не находится.
Отравление памяти
Prompt injection заражает текущий контекст. Отравление памяти заражает будущее поведение агента. Допустим, вы поставили зловредный плагин или MCP-сервер, и он дописал куда-нибудь в AGENTS.md фразу, которую вы не сразу заметите. Эта фраза переживёт сессию, а если память глобальная, будет работать для всей машины, и через неё могут утечь данные.
Этот вектор атаки уже измерили. В июньском исследовании атаки на память сравнивали на двух агентах6. У Hermes, который пишет и подтягивает память агрессивно, средняя доля успешных атак — 66,67%, у более консервативного OpenClaw — 34,25%. Лучшая атака на Hermes срабатывала в 85,17% случаев. Вывод авторов: чем агрессивнее агент пишет и достаёт память, тем легче его атаковать. Фильтры от prompt injection помогают плохо. Выдуманный факт, ложный прошлый опыт или вредная процедура синтаксически ничем не отличаются от нормального текста; лучший результат на слабосигнальных атаках в этой работе — 42,5%. Hermes — мой основной агент, и в исследовании он оказался как раз агрессивным.
Отравленную запись можно заметить, объяснить и откатить, если память доступна для ревью. У полностью фоновой памяти все три шага намного сложнее. Markdown в git diff — самый дешёвый способ получить это свойство.
Что есть на рынке
Есть сравнительная таблица систем памяти для кодинг-агентов, где всё сведено в одно место7. На дату проверки в ней 86 систем и 79 признаков, и я попросил агентов разобрать её целиком. Таблицу ведёт автор одной из этих систем, YesMem, и сам это указывает, так что смотреть на неё стоит с долей скепсиса. Как список систем и вопросов она полезна. Как точная статистика рынка — уже нет.
Если считать строго по data.js, то у 33 из 86 систем одновременно не отмечены ни decay, ни supersede, ни contradiction detection — 38,4%. Экспорт отмечен у 31 из 86, MCP — у 63; у 15 нет ни MCP, ни хуков, ни плагина. Но у таблицы есть внутренний дрейф: например, строка Hindsight в data.js не отмечает supersede и contradiction detection, а её же evidence-файл отмечает оба пункта как подтверждённые7. Поэтому эти проценты я больше не выдаю за измерение рынка. Это пересчёт конкретной версии чужой таблицы, где даже сводка и доказательства иногда расходятся.
Отсутствие кнопки экспорта тоже ещё не приговор: если всё лежит в Markdown, SQLite или вашем PostgreSQL, знания вы и так заберёте. Хуже, когда они лежат в своей базе в нечитаемом виде. И наоборот, галочка в таблице не доказывает, что экспорт удаляет или переносит все производные данные.
С бенчмарками отдельная ловушка. Цифры публикуют сами проекты, и нередко их показывает облачная версия, а ставите вы открытую. У Mem0, например, в таблице различий графовая память, decay, temporal reasoning и экспорт относятся к платформе и не поддерживаются в OSS SDK8.
Поэтому вместо звёзд и бенчмарков я смотрю на пять вопросов. Что система записывает: все сообщения, факты, эпизоды или правила? Как она разрешает противоречия: только добавляет или умеет обновлять, заменять и закрывать интервал? Можно ли понять, почему агент что-то вспомнил, то есть видно ли, откуда взялся факт? Можно ли удалить память полностью — не только строку, но и эмбеддинги, индексы и рёбра графа? И можно ли забрать её с собой? Бенчмарк не отвечает ни на один из этих вопросов.
Что стоит у меня
У моего основного агента Hermes9 память на Hindsight. Я выбирал его, сравнивая с Honcho и Mem0. Hindsight раскладывает то, что узнал, на факты о мире, опыт агента, наблюдения из многих записей и ментальные модели. Внутри есть граф и время, а наблюдения уточняются по мере появления подтверждений и противоречий.
В новых версиях Hindsight появился отдельный пакет @vectorize-io/hindsight-coding-agents. Он подключается сразу к нескольким coding agents и по умолчанию даёт им один банк на репозиторий10. Claude Code, Codex и другие агенты видят одну память проекта; связанные worktree тоже попадают в тот же банк. При первом запуске плагин забирает историю git и делает read-only обзор кодовой базы, затем дописывает новые коммиты и сессии. Старые локальные транскрипты можно импортировать отдельно.
Меня тут больше всего заинтересовали Knowledge Pages: страницы про архитектуру, соглашения, решения и текущие инициативы, которые поддерживает сама память. На первом запросе сессии плагин один раз вызывает reflect по её цели и подмешивает синтезированный результат. Дальше он не делает тяжёлый recall перед каждым сообщением: агент может быстро искать по страницам или явно вызвать глубокий reflect, когда вопрос изменился. В конце сессия записывается обратно. Это уже отдельный контур проектной памяти поверх git и разговоров, а не просто база фактов.
После этого мой совет «начинайте с файлов» звучит уже не так просто. Плагин не отменяет файлы и git как источники правды — он строит над ними производную проекцию и добавляет то, чего в репозитории нет: решения из разговоров. Это гораздо убедительнее, чем идея «сохраним все чаты и поищем похожее». Но цена никуда не делась: эмбеддинг, реранкер, LLM на извлечении и консолидации, плюс фоновая индексация. Новые тихие сбои тоже остались. У плагина поэтому появились отдельные JSONL-логи reflect, fallback и использования memory tools, а команда stats показывает, пользуются ли агенты памятью вообще10.
Для моего персонального ассистента Hindsight подходит лучше альтернатив, которые я смотрел, а coding-agent plugin делает его интересным и для долгоживущих проектов. Я пока не готов назвать его заменой обычным файлам: скорее это первый вариант сложной памяти, где я вижу осмысленную архитектуру именно для кодинга, а не прикрученный к транскриптам semantic search. Свою базу знаний я всё равно держу отдельно: агент может её читать, но автоматические записи идут в его память.
Смотрел я и Holographic, и Honcho, и много чего ещё. У популярного claude-mem нет ни одного из семи механизмов жизненного цикла, которые проверяет сравнительная таблица11. Это не делает его бесполезным, но в моей рамке это индексированный журнал сессий, а не полноценная память. А недавно поставил deja-vu12. Он берёт транскрипты агентов, которые уже лежат на диске, — Claude Code, Codex и других — и индексирует их локально, без LLM и без оплаты токенов. Потом через хуки подмешивает в разговор найденные по словам воспоминания. Если подключить локальную эмбеддинг-модель, он начинает находить и перефразированные запросы.
С чего начать
Если свести всё к дереву решений, получится так. Нужно переносить знание между сессиями? Если нет — остановитесь, память не нужна. Если да и фактов мало, складывайте их в обычные файлы: вы увидите каждый факт в диффе при коммите и вовремя его поправите. Фактов много — нужен поиск. Нужны отношения между сущностями — граф. Нужно рассуждать по истории — время. А отдавать ли управление памятью самой модели — отдельная ось, её можно надстроить над любым хранилищем, но тогда сразу с логами.
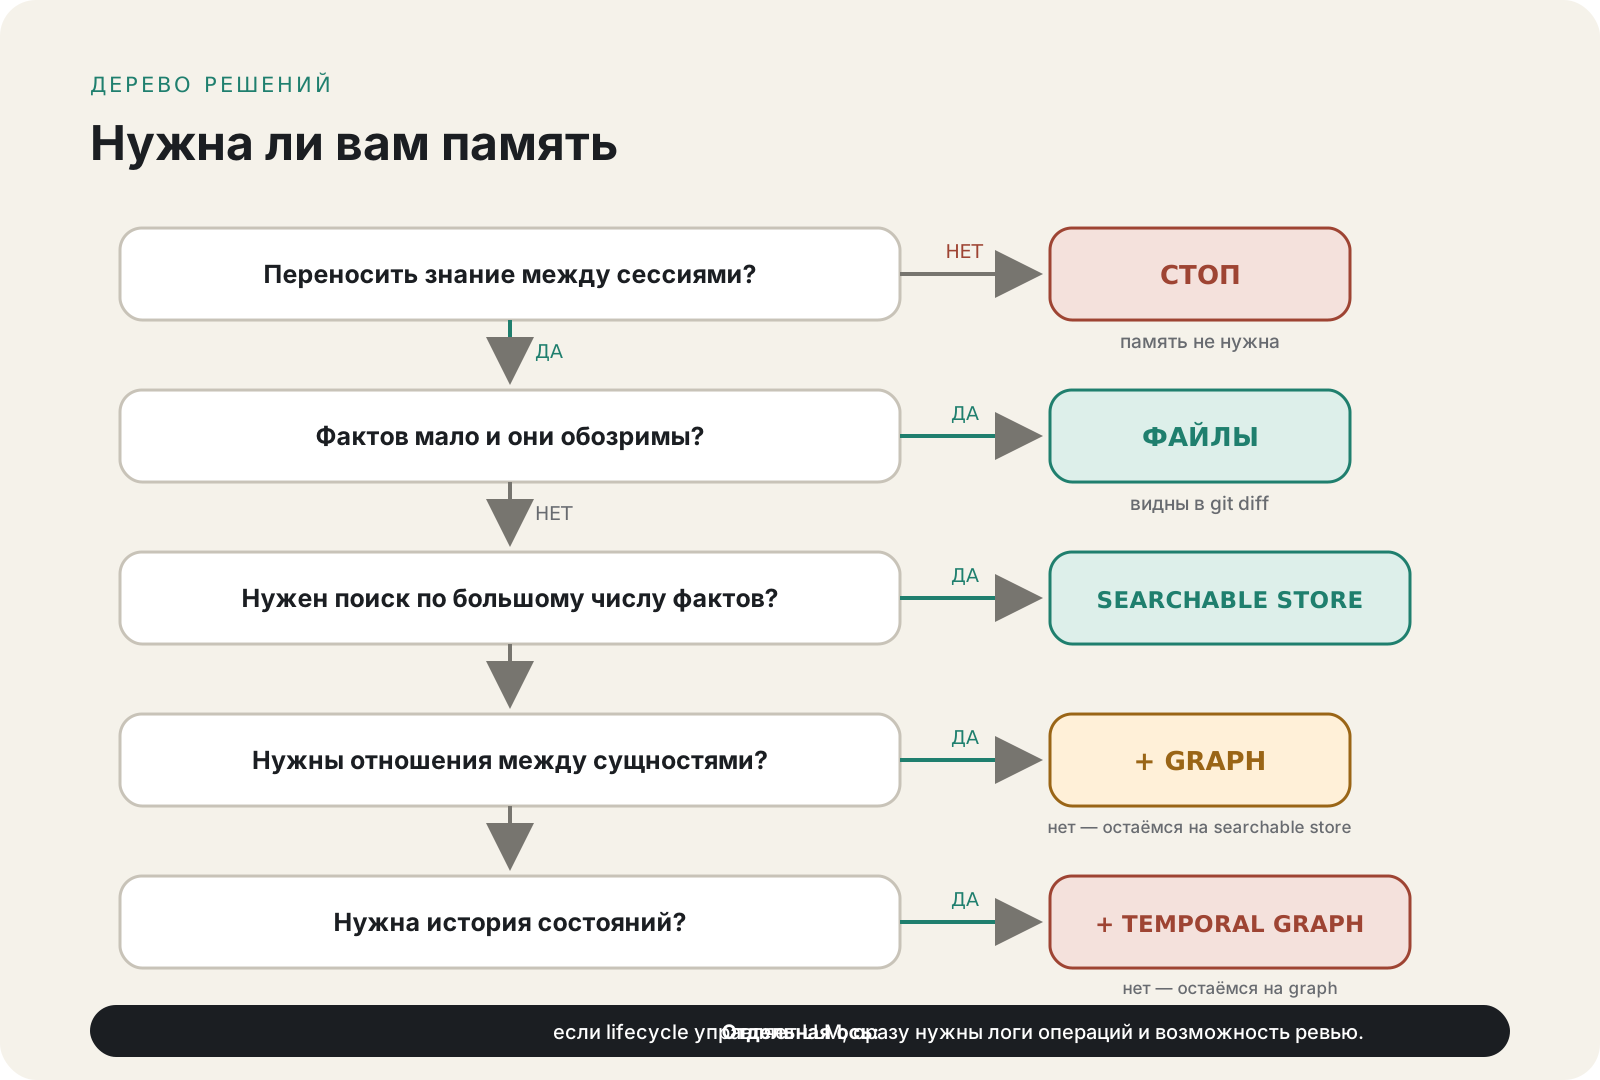
Поэтому я советую начать скучно: факты и правила в обычных файлах. Заметили, что агент где-то тупит, — попросите его записать это в файл. Не хватает поиска по смыслу — добавьте векторы. Не хватает связей — граф. Нужна история состояний — время. Нужна автономная консолидация и общая память нескольких агентов — тогда уже Hindsight или другой менеджер памяти. Если проблемы у вас пока нет, не пытайтесь её решить.
Файлы перестают справляться, когда фактов становится больше, чем разумно загружать в контекст, или когда агент живёт с вами долго. Теперь сюда добавился третий случай: несколько coding agents должны разделять историю решений одного проекта. Для последних двух случаев я сам использую Hindsight и плачу за это токенами.
Что я забираю с собой
- Память начинается с жизненного цикла: что записать, чему верить, что заменить и когда забыть.
- Вектор ищет похожее. Истинность, отношения и время требуют других механизмов.
- Если факты помещаются в файл, базы пока не нужны.
- Когда жизненным циклом управляет модель, без логов и ревью память превращается в тихий источник ошибок.
- Hindsight с новым coding-agent plugin — уже не поиск по архиву сессий: это общий банк репозитория, git, Knowledge Pages и синтез на старте работы. Цена сложной памяти всё равно остаётся.
- Архитектура усложняется в ответ на проблему, которую можно назвать.
В конце доклада я спросил, никого ли не зацепило, что агентам память не нужна. Мне ответили, что не нужна в таком виде, и с этим я согласен. Все системы памяти я физически проверить не могу, так что если вы пробовали что-то, что у вас действительно работает, напишите. Особенно интересно, как вы решаете забывание.
Источники
-
How Claude remembers your project — «Auto memory is machine-local. All worktrees and subdirectories within the same git repository share one auto memory directory. Files are not shared across machines or cloud environments.» ↩
-
Lost in the Middle: How Language Models Use Long Contexts — «performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts» ↩
-
Context Rot: How Increasing Input Tokens Impacts LLM Performance — «Even a single distractor reduces performance relative to the baseline (needle only), and adding four distractors compounds this degradation further.» ↩
-
LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory — «a comprehensive benchmark designed to evaluate five core long-term memory abilities of chat assistants: information extraction, multi-session reasoning, temporal reasoning, knowledge updates, and abstention.» Про префиксный кэш: Anthropic, Prompt caching — «Prompt caching works by referencing the entire prefix —
tools, thensystem, thenmessages(in that order) — up to and including the block designated withcache_control.» ↩ -
openai/codex: stage_one_system.md — «No-op is allowed and preferred when there is no meaningful, reusable learning worth saving.» ↩
-
From Untrusted Input to Trusted Memory: A Systematic Study of Memory Poisoning Attacks in LLM Agents — «HERMES is substantially more susceptible across all attack classes, with an average ASR of 66.67% compared to 34.25% on OpenClaw.» В таблицах той же работы: Salience-Driven Compaction для HERMES — 85,17%, лучший результат PromptArmor на слабосигнальных атаках — 42,50%. ↩
-
AI Memory Systems — Feature Comparison, зафиксированный
data.jsи evidence по Hindsight — «This comparison is maintained by the author of YesMem. YesMem is listed alongside every other system and follows the same evidence rules.» Пересчёт сделан поdata.jsна этом коммите; расхождение по Hindsight видно между сводной строкой и evidence-файлом того же коммита. ↩ ↩2 -
Mem0: Platform vs Open Source — в сравнительной таблице для OSS указано: «Graph Memory: No», «Memory Decay: Not supported», «Temporal Reasoning: Not supported», «Memory Export: Not available». ↩
-
Hindsight: Coding Agents — «a shared reflect-and-inject core with a thin entry point per agent»; «a repo’s git history and conversations flow into its memory bank in the background as you work»; «keeps a curated set of knowledge pages (architecture, conventions, in-flight initiatives)». Текущая версия пакета на этом коммите — 0.6.1. Диагностика и
statsописаны в том же README. ↩ ↩2 -
AI Memory Systems — Feature Comparison: claude-mem — «No Ebbinghaus decay, no supersede chains, no contradiction detection, no quarantine/skip_indexing, no auto-resolution of tasks, no trust model, no explicit forget mechanism» ↩
-
vshulcz/deja-vu — «deja indexes the sessions Claude Code, Codex, Cursor and every other agent on this machine already wrote to disk» ↩